Proxy IA ou passerelle LLM : quelle est la différence ?
Distinguez le relais réseau, une passerelle API et le routage de modèles pour choisir la couche qui correspond à la tâche.
On dit « proxy IA » pour trois boîtes différentes : un relais réseau, une passerelle API inverse, et un routeur de modèles. Ce guide s'adresse aux développeurs qui doivent choisir une couche sans mélanger leurs métiers. Il ne vend pas d'adresses IP, ne distribue pas de clés, et n'affirme pas qu'un proxy change l'éligibilité d'un compte ou d'une géographie.
01Ce que les gens veulent généralement dire par « proxy IA »
L'expression n'est pas une norme. RFC 9110 (HTTP Semantics, juin 2022, STD 97) sépare déjà les intermédiaires en proxy, passerelle et tunnel, et prévient qu'un même processus peut changer de rôle par requête. Dans les textes marketing, le même mot est réutilisé pour encore autre chose : un processus qui accepte un corps JSON façon OpenAI et choisit un modèle.
Ces trois métiers se ressemblent sur un schéma parce que chacun s'assoit entre votre client et quelque chose en amont. Ils échouent à des endroits différents. Un proxy forward peut ouvrir un tunnel TCP et vous laisser quand même avec un 401 fournisseur. Une passerelle LLM peut renvoyer HTTP 200 avec une erreur JSON sur un modèle inconnu alors que le chemin réseau était bon. Si vous déboguez la mauvaise couche, vous ferez tourner le mauvais secret.
Une exécution locale bornée le 15 octobre 2026 a rendu cette scission concrète. Un proxy HTTP CONNECT en loopback a relayé le TLS vers une origine de montage. Un processus loopback séparé a routé fixture-alpha contre fixture-bravo après un contrôle Bearer local. Rien n'a quitté 127.0.0.1. Rien n'a appelé une API de modèle payante. Le JSON du montage est étiqueté CONTROLLED_FIXTURE_NOT_A_PROVIDER exprès.
Quand un vendeur nomme un produit « AI proxy », lisez lequel de ces métiers il implémente réellement. Ne supposez pas que les nouvelles tentatives, le streaming ou le repli existent parce que le mot gateway apparaît sur la page d'accueil.
02Proxies HTTP et SOCKS forward, y compris CONNECT
Un proxy forward est choisi par le client. RFC 9110 §3.7 l'appelle un agent de relais de messages qui reçoit des requêtes pour certaines URI absolues et essaie de les satisfaire via HTTP. Pour les URL http ordinaires, le client envoie l'URL complète au proxy. Pour https, le motif habituel est différent.
RFC 9110 §9.3.6 définit CONNECT : le client demande au proxy de construire un tunnel vers host:port et, après tout 2xx, de se limiter à un relais aveugle jusqu'à la fermeture du tunnel. Les tunnels sont couramment enveloppés dans du TLS ensuite. Un CONNECT réussi n'est pas un succès applicatif. Cela veut seulement dire que le tunnel existe. Toute autre réponse veut dire que le tunnel n'a pas été formé.
SOCKS5 est plus ancien et s'assoit plus bas. RFC 1928 (mars 1996) le décrit comme une cale entre l'application et le transport, conventionnellement sur TCP 1080. Après la négociation de méthode, le client envoie une commande ; CONNECT est X'01'. SOCKS n'analyse pas les méthodes HTTP. Il relaie le TCP (et optionnellement l'UDP) vers une destination que le client nomme.
Si votre bibliothèque HTTP parle HTTPS à travers un proxy, elle fait en général CONNECT, puis du TLS vers l'origine. Le proxy authentifie le tunnel, souvent avec Proxy-Authorization. Cet en-tête n'est pas l'en-tête Authorization: Bearer que l'API de modèle attend. Les mélanger est une source fréquente de « le proxy marche dans curl mais le SDK 401 encore ».
Si la tâche est seulement « ce processus doit sortir par une autre IP », partez des listes de proxies HTTP, proxies HTTPS et proxies SOCKS5. Ces pages comparent des sorties. Ce ne sont pas des routeurs de modèles.
03Proxies inverses et passerelles API ordinaires
Un proxy inverse, que RFC 9110 appelle aussi une passerelle au §3.7, se présente comme l'origine au client et relaie l'entrant vers un autre serveur. Le client ne l'a pas choisi comme URL de proxy. Le client a seulement ouvert https://api.example.com.
Le guide de proxy inverse NGINX (consulté le 15 octobre 2026) décrit la boucle mécanique : envoyer la requête à un amont proxy_pass, récupérer la réponse, la renvoyer. Par défaut NGINX réécrit Host et Connection. Ce détail compte pour les API qui calent les hôtes virtuels sur Host. Un proxy inverse peut terminer le TLS sur le bord public et ouvrir une nouvelle connexion à l'intérieur. La session TLS du client s'arrête alors au proxy inverse, pas chez le vendeur de modèles.
Cette couche est le bon outil pour le routage de chemins (/v1/ contre /admin/), l'équilibrage de charge, le nettoyage d'en-têtes, et l'exposition d'un seul nom d'hôte devant plusieurs services internes. Elle peut ne pas savoir ce qu'est un nom de modèle. Si elle ne fait que relayer /v1/chat/completions vers un seul amont, c'est encore une passerelle API au sens HTTP, pas une passerelle LLM.
Ne traitez pas « on a mis NGINX devant » comme une preuve de nouvelles tentatives, de budgets de jetons ou de repli de modèle. Ce sont des fonctionnalités supplémentaires que certains produits ajoutent. La page NGINX que nous avons lue ne les revendique pas.
04Passerelles LLM : clés, limites, routage et journaux
Une passerelle LLM est un service applicatif. Les clients envoient un corps de chat ou d'embeddings vers une URL. La passerelle vérifie une clé virtuelle, peut imposer des budgets, peut choisir un fournisseur et un modèle, peut journaliser les jetons, et seulement ensuite parle à un vendeur — ou à plusieurs vendeurs.
La page AI Gateway de LiteLLM (HTTP 200 le 15 octobre 2026) décrit un serveur auto-hébergé qui offre un point d'accès compatible OpenAI. Les métiers documentés incluent des clés virtuelles avec modèles et limites de débit par clé, le suivi des dépenses, l'équilibrage de charge, les replis, les nouvelles tentatives, les garde-fous et la journalisation. La même page dit : si un client peut utiliser l'API OpenAI, il peut utiliser la passerelle sans changer le code client. C'est une revendication produit sur la forme de la requête chat completions. Ce n'est pas une preuve que chaque point d'accès, en-tête et erreur OpenAI se mappe 1:1. Nous n'avons ni installé ni exécuté LiteLLM.
Cloudflare AI Gateway (dateModified de la page 2026-04-20, récupérée le 15 octobre 2026) liste l'analytique, la journalisation, le cache, le rate limiting, les nouvelles tentatives de requête et le repli de modèle comme fonctionnalités. La page de routage dynamique (mise à jour le 2 octobre 2026) est plus précise sur la compatibilité : les routes dynamiques n'acceptent que la forme de requête chat completions OpenAI ; Anthropic Messages renvoie HTTP 400. Cette phrase est la raison pour laquelle « compatible OpenAI » doit rester étroit. Nous n'avons pas appelé Cloudflare et nous n'avons pas exécuté de nouvelles tentatives ni de repli. Si un document de passerelle liste ces fonctionnalités, traitez-les comme source seulement jusqu'à ce que vous les exécutiez contre ce produit.
En local, nous avons construit un tout petit routeur qui n'est pas ces produits. Il a accepté Authorization: Bearer local-demo-key-not-a-provider-secret, mappé fixture-alpha et fixture-bravo vers deux charges de montage, renvoyé 401 sans jeton local valide, et renvoyé 400 pour un modèle inconnu. Cela suffit à montrer que le plan de contrôle s'assoit dans le JSON HTTP, pas dans CONNECT.
05Suivre une requête : TLS, Host, et qui peut lire le corps
Parcourez un POST /v1/chat/completions à travers les deux conceptions.
Chemin forward utilisé dans l'exécution loopback : le client a ouvert du TCP vers 127.0.0.1:54318, envoyé CONNECT 127.0.0.1:54316 HTTP/1.1, reçu 200 Connection Established, puis terminé le TLS vers le certificat d'origine. Seulement après le TLS a-t-il envoyé le corps JSON et un en-tête Bearer destiné à l'origine. Le processus CONNECT a journalisé la cible 127.0.0.1:54316. Il n'a pas vu le JSON du montage ni le jeton Bearer : la liste des fragments de corps HTTP observés sur le tunnel était vide. Le TLS s'est arrêté à l'origine du montage. L'origine a répondu HTTP 200 avec le montage contrôlé.
Chemin passerelle : le client a ouvert du TCP vers 127.0.0.1:54317 sans CONNECT. Le TLS n'a pas été utilisé sur ce saut dans la démo (HTTP en clair en loopback). La passerelle a lu le champ JSON model et le jeton Bearer local avant qu'une origine n'existe pour cette requête. Une auth locale manquante ou fausse n'a jamais atteint un montage de modèle comme route réussie ; les deux ont produit HTTP 401 avec invalid_local_gateway_auth. Un modèle inconnu a produit HTTP 400 avec unsupported_model_or_route après que l'auth a réussi. Le transport était debout. L'application a refusé le travail.
En HTTPS de production, une passerelle LLM termine presque toujours le TLS. Elle le doit, si elle va parser du JSON, appliquer un budget, ou choisir un modèle. Un proxy forward CONNECT qui n'est pas une boîte intermédiaire TLS ne termine pas ce TLS d'origine. Si quelqu'un active l'inspection HTTPS sur un proxy d'entreprise, c'est un déploiement différent : le proxy devient un client TLS vers l'origine et un serveur TLS vers vous. Ne supposez pas l'inspection simplement parce que CONNECT a réussi.
L'aperçu de l'API OpenAI (récupéré le 15 octobre 2026 ; le platform.openai.com/docs/api-reference demandé a redirigé ici) documente des identifiants Bearer sur la requête d'origine. Il traite x-request-id comme un identifiant de corrélation de requête, séparé des en-têtes de limite de débit tels que x-ratelimit-limit-requests. Ces champs appartiennent à la conversation fournisseur. Une passerelle peut ajouter ses propres identifiants de requête. Un proxy forward ne le fait en général pas.
06La compatibilité est une forme client, pas toute l'API
Les SDK laissent souvent poser base_url et continuer à utiliser chat.completions.create. Les vendeurs appellent cela compatible OpenAI. La note de routage dynamique de Cloudflare est la mise en garde : même à l'intérieur d'un vendeur, un chemin de compatibilité peut n'accepter qu'une forme de requête et 400 une autre.
Un point d'accès compatible peut encore différer en authentification (clé virtuelle contre clé fournisseur), noms de modèles (gpt-4.1 contre azure/gpt-4.1 contre un alias de passerelle), mises en page d'événements de streaming, champs d'appels d'outils, envois de fichiers, sockets temps réel, et API d'administration. L'aperçu d'OpenAI lui-même traite Responses, Realtime et Administration comme des surfaces séparées. Copier /v1/chat/completions ne copie pas tout cet arbre.
La passerelle loopback a renvoyé du JSON qui ressemble à une complétion de chat (choices[0].message). C'était un montage. Cela ne rend pas la démo « compatible OpenAI » dans un sens produit.
07Trois sortes différentes de « ça a marché »
Gardez ces trois résultats séparés quand vous lisez les journaux.
| Couche | Exemple de succès | Exemple d'échec | Ce que cela ne prouve pas |
|---|---|---|---|
| Transport / tunnel | CONNECT 200 Connection Established ; réponse SOCKS CONNECT | Proxy 403, délai, erreur de négociation TLS | Le modèle a accepté le prompt ou la clé |
| HTTP vers le saut suivant | 200 ou même 401/400 avec un corps JSON | Réponse vide, RST, HTTP 502 d'un proxy inverse | Le JSON est un résultat de modèle |
| Application / route de modèle | La passerelle mappe fixture-alpha vers le montage alpha ; le fournisseur renvoie une complétion | Passerelle 400 modèle non pris en charge ; fournisseur 401 clé API invalide ; refus de sécurité du modèle à l'intérieur d'un HTTP 200 | Les autres couches sont saines, ou qu'un second vendeur se comporterait de la même façon |
Le 15 octobre 2026, le script local a enregistré six cas et seize assertions, toutes passées, avec Python 3.9.6 et LibreSSL 3.3.6 :
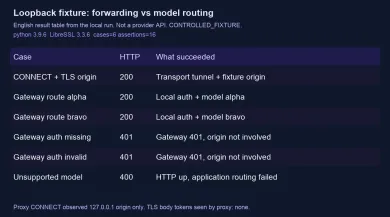
Le relais a produit HTTP 200 d'origine. Le routage de passerelle a produit deux routes de montage différentes. Les échecs d'auth sont restés à la passerelle avec 401. Le modèle non pris en charge est resté à la passerelle avec 400. Nouvelles tentatives, streaming et replis n'ont pas été exécutés et ne sont pas revendiqués.
La page Mon IP rapporte l'adresse qui a atteint cette page depuis votre navigateur. Le vérificateur de proxies est une sonde côté serveur d'un point d'accès que vous fournissez. Ni l'un ni l'autre ne montre la route qu'un processus SDK Python empruntera, et ni l'un ni l'autre n'établit l'éligibilité à une API LLM. Le vérificateur ne prouve pas qu'un vendeur de modèles acceptera une IP, qu'une clé est valide, ou que vous êtes autorisé à utiliser un compte donné.
08Choisir la couche qui correspond à la tâche
Utilisez un proxy forward HTTP CONNECT ou SOCKS5 quand le problème est d'où la session TCP sort — une sortie d'entreprise, un portable de développement qui n'atteint pas un vendeur, ou une sortie datacenter ou mobile publiée. Configurez les réglages proxy du SDK (ou HTTPS_PROXY) et gardez la clé API fournisseur sur la requête que l'origine verra. N'attendez pas du proxy qu'il choisisse des modèles.
Utilisez un proxy inverse ou une passerelle API générique quand le problème est un nom d'hôte, beaucoup de services internes, le TLS au bord, ou une politique d'en-têtes. Pointez le DNS vers cette passerelle. N'attendez pas qu'elle connaisse la dépense de jetons sauf si vous l'avez ajouté vous-même.
Utilisez une passerelle LLM quand le problème est beaucoup de clients, beaucoup de modèles, une politique. Émettez des clés virtuelles, posez des budgets, journalisez les prompts si votre politique le permet, et mappez des alias sur des modèles fournisseur. Gardez les clés fournisseur sur l'hôte de la passerelle, pas dans chaque portable. Lisez les notes de compatibilité actuelles du vendeur ; ne supposez pas les nouvelles tentatives ou les replis. Si vous n'avez qu'un processus Python et pas de politique partagée, une passerelle peut être des pièces mobiles en trop — la documentation de LiteLLM elle-même sépare « passerelle contre SDK » sur cet axe.
Liste de contrôle avant d'acheter ou de construire :
- Notez l'échec que vous avez réellement vu : TCP, TLS, statut HTTP, ou erreur JSON.
- Nommez qui termine le TLS.
- Nommez quel secret est pour le tunnel, lequel pour la passerelle, et lequel pour le fournisseur.
- Nommez la chaîne de modèle que le client envoie et la chaîne que le fournisseur attend.
- Confirmez si le streaming, les nouvelles tentatives et le repli sont documentés et testés sur ce produit. Si vous ne les avez pas exécutés, ne les revendiquez pas.
- Confirmez la forme de requête client (chat completions contre un autre schéma).
- Si vous n'aviez besoin que d'une IP de sortie différente, arrêtez-vous au proxy forward et sautez le routeur de modèles.
Le tableau numéroté et la figure WebP ci-dessus viennent d'une exécution loopback CONNECT+TLS séparée le même jour. Ce laboratoire est du relais réellement choisi par le client : HTTP CONNECT, puis TLS vers l'origine. Ce n'est pas la recette copier-coller ci-dessous.
Cette recette publique est du HTTP en clair sur 127.0.0.1 seulement. Elle n'ouvre pas de tunnel CONNECT, n'utilise pas le TLS, et n'appelle pas un vendeur de modèles. Son saut Forward poste toujours vers un origin_port fixe, et le client utilise un chemin en forme d'origine (/v1/chat/completions). Au sens de RFC 9110, c'est un passage inverse, amont fixe, pas un proxy HTTP forward choisi par le client. Comparez ce saut avec le routeur de modèles applicatif dans le même script. Ne lisez pas forward_http dans la sortie attendue comme une preuve d'un proxy forward choisi par le client.
Préparation : Python 3.9 ou plus récent. Bibliothèque standard seulement. Pas de paquets. Pas de clés API.
- Enregistrez le script suivant sous forwarding_vs_routing.py dans un répertoire que vous possédez.
- Exécutez : python3 forwarding_vs_routing.py
- Votre stdout doit correspondre à la sortie attendue après le script.
#!/usr/bin/env python3
"""Plain-HTTP loopback demo: forwarding vs model routing. Stdlib only."""
from __future__ import annotations

import json
import threading
from http.client import HTTPConnection
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

BIND = "127.0.0.1"
KEY = "***"
LABEL = "CONTROLLED_FIXTURE_NOT_A_PROVIDER"
TIMEOUT = 5


class Origin(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"

    def log_message(self, *_args):
        return

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        self.rfile.read(n)
        body = json.dumps(
            {
                "label": LABEL,
                "origin": "loopback-http-origin",
                "choices": [
                    {
                        "index": 0,
                        "message": {
                            "role": "assistant",
                            "content": "FIXTURE: forwarded origin",
                        },
                    }
                ],
            }
        ).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(body)


class Gateway(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    ROUTES = {
        "fixture-alpha": {"label": LABEL, "route": "alpha"},
        "fixture-bravo": {"label": LABEL, "route": "bravo"},
    }

    def log_message(self, *_args):
        return

    def _send(self, code, obj):
        raw = json.dumps(obj).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(raw)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(raw)

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        raw = self.rfile.read(n)
        auth = self.headers.get("Authorization") or ""
        try:
            model = json.loads(raw.decode() or "{}").get("model")
        except json.JSONDecodeError:
            model = None
        if auth != "Bearer " + KEY:
            self._send(401, {"error": "invalid_local_gateway_auth", "label": LABEL})
            return
        route = self.ROUTES.get(model)
        if route is None:
            self._send(
                400,
                {
                    "error": "unsupported_model_or_route",
                    "requested": model,
                    "label": LABEL,
                },
            )
            return
        self._send(200, route)


class Forward(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    origin_port = 0

    def log_message(self, *_args):
        return

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        body = self.rfile.read(n)
        upstream = HTTPConnection(BIND, self.origin_port, timeout=TIMEOUT)
        try:
            skip = {"host", "proxy-connection"}
            headers = {k: v for k, v in self.headers.items() if k.lower() not in skip}
            upstream.request("POST", self.path, body=body, headers=headers)
            resp = upstream.getresponse()
            data = resp.read()
            status = resp.status
            ctype = resp.getheader("Content-Type") or "application/json"
        finally:
            upstream.close()
        self.send_response(status)
        self.send_header("Content-Type", ctype)
        self.send_header("Content-Length", str(len(data)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(data)


def start(handler):
    httpd = ThreadingHTTPServer((BIND, 0), handler)
    httpd.daemon_threads = False
    httpd.timeout = 0.3
    thread = threading.Thread(
        target=httpd.serve_forever,
        name="srv-%s" % httpd.server_address[1],
        daemon=False,
    )
    thread.start()
    return httpd, thread


def post(port, path, payload, headers):
    conn = HTTPConnection(BIND, port, timeout=TIMEOUT)
    try:
        raw = json.dumps(payload).encode()
        hdrs = {"Content-Type": "application/json"}
        hdrs.update(headers)
        conn.request("POST", path, body=raw, headers=hdrs)
        resp = conn.getresponse()
        return resp.status, json.loads(resp.read().decode())
    finally:
        conn.close()


def main():
    origin_httpd = gw_httpd = fwd_httpd = None
    threads = []
    try:
        origin_httpd, origin_thread = start(Origin)
        threads.append(origin_thread)
        Forward.origin_port = origin_httpd.server_address[1]
        fwd_httpd, fwd_thread = start(Forward)
        threads.append(fwd_thread)
        gw_httpd, gw_thread = start(Gateway)
        threads.append(gw_thread)

        ping = {
            "model": "ignored-by-forward",
            "messages": [{"role": "user", "content": "ping"}],
        }
        rows = []
        status, body = post(
            fwd_httpd.server_address[1],
            "/v1/chat/completions",
            ping,
            {"Authorization": "***"},
        )
        rows.append(("forward_http", status, body.get("origin") or body.get("error")))
        assert status == 200
        assert body.get("label") == LABEL
        assert body.get("origin") == "loopback-http-origin"

        gw = gw_httpd.server_address[1]
        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_route_alpha", status, body.get("route") or body.get("error")))
        assert status == 200 and body.get("route") == "alpha"

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-bravo", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_route_bravo", status, body.get("route") or body.get("error")))
        assert status == 200 and body.get("route") == "bravo"

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {},
        )
        rows.append(("gateway_auth_missing", status, body.get("error")))
        assert status == 401

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {"Authorization": "***"},
        )
        rows.append(("gateway_auth_invalid", status, body.get("error")))
        assert status == 401

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "no-such-model", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_unsupported_model", status, body.get("error")))
        assert status == 400

        print("CONTROLLED_FIXTURE public recipe — not a provider call, not TLS")
        for name, status, extra in rows:
            print("%s HTTP %s %s" % (name, status, extra))
        print("assertions=6 ok")
        return 0
    finally:
        for httpd in (origin_httpd, gw_httpd, fwd_httpd):
            if httpd is not None:
                httpd.shutdown()
                httpd.server_close()
        for thread in threads:
            thread.join(timeout=TIMEOUT)


if __name__ == "__main__":
    raise SystemExit(main())
Sortie attendue :
CONTROLLED_FIXTURE public recipe — not a provider call, not TLS
forward_http HTTP 200 loopback-http-origin
gateway_route_alpha HTTP 200 alpha
gateway_route_bravo HTTP 200 bravo
gateway_auth_missing HTTP 401 invalid_local_gateway_auth
gateway_auth_invalid HTTP 401 invalid_local_gateway_auth
gateway_unsupported_model HTTP 400 unsupported_model_or_route
assertions=6 ok
La ligne forward_http est ce passage à amont fixe. Le laboratoire CONNECT+TLS du tableau et du WebP reste la preuve du relais.
Un proxy réseau change-t-il la clé d'API de modèle que je dois envoyer ?
HTTP CONNECT lit-il le corps JSON TLS ?
Pourquoi l'auth de passerelle est-elle différente de l'auth fournisseur ?
Que veut dire réellement « compatible OpenAI » ?
SOCKS5 peut-il remplacer HTTP CONNECT pour les API de modèles HTTPS ?
Le vérificateur de proxies prouve-t-il qu'une API LLM acceptera cette IP ?
Toutes les passerelles LLM font-elles les nouvelles tentatives, le repli et le streaming de la même façon ?
Articles associés
Qu'est-ce qu'un proxy résidentiel et comment ça marche
Les proxies résidentiels sortent par des adresses d'opérateur grand public. Pools, sessions sticky, ce que le site voit, et quoi demander au fournisseur avant d'acheter.
4 min de lectureMeilleurs proxies pour le web scraping en 2026 : une liste de contrôle d'achat
Un achat de scraping en 2026 commence par la cible, pas par un fournisseur. Utilisez cette liste pour l'origine, la session, la géo, la facturation, et un test en direct avant de monter.
5 min de lectureProxies sticky ou rotatifs : le contrôle de session expliqué
Proxies sticky ou rotatifs : rotation à chaque requête ou sur minuterie, quand une session sticky bat une nouvelle IP, comment les cookies réagissent à un changement d'IP, et comment tester un identifiant de session.
8 min de lecture
