AI proxy a brama LLM: czym się różnią
Rozróżnić przekazywanie sieciowe, bramę API i routing modeli, żeby wybrać warstwę, która pasuje do zadania.
Ludzie mówią „AI proxy” na trzy różne pudełka: przekazywacz sieciowy, odwrotną bramę API i router modeli. Ten przewodnik jest dla programistów, którzy muszą wybrać jedną warstwę, nie mieszając ich zadań. Nie sprzedaje adresów IP, nie rozdaje kluczy i nie twierdzi, że proxy zmienia uprawnienie konta albo geografii.
01Co ludzie zwykle mają na myśli, mówiąc „AI proxy”
To sformułowanie nie jest standardem. RFC 9110 (HTTP Semantics, czerwiec 2022, STD 97) już dzieli pośredników na proxy, bramę i tunel, i ostrzega, że jeden proces może zmieniać rolę per żądanie. W copy produktowym to samo słowo jest używane jeszcze do czegoś innego: procesu, który przyjmuje ciało JSON w stylu OpenAI i wybiera model.
Te trzy zadania wyglądają podobnie na diagramie, bo każde siedzi między waszym klientem a czymś upstream. Padają w różnych miejscach. Proxy forward potrafi otworzyć tunel TCP i nadal zostawić was z 401 od dostawcy. Brama LLM potrafi zwrócić HTTP 200 z błędem JSON o nieznanym modelu, podczas gdy ścieżka sieciowa była w porządku. Jeśli debugujecie złą warstwę, będziecie rotować zły sekret.
Ograniczony lokalny przebieg z 2026-10-15 uczynił ten podział konkretnym. Proxy HTTP CONNECT na loopback przekazywało TLS do atrapy origin. Osobny proces na loopback routował fixture-alpha kontra fixture-bravo po lokalnym sprawdzeniu Bearer. Nic nie opuściło 127.0.0.1. Nic nie wołało płatnego API modelu. JSON atrapy jest celowo oznaczony CONTROLLED_FIXTURE_NOT_A_PROVIDER.
Gdy sprzedawca nazywa produkt „AI proxy”, odczytać, które z tych zadań naprawdę implementuje. Nie zakładać ponowień, streamingu ani fallback tylko dlatego, że na stronie głównej pojawia się słowo gateway.
02Proxy forward HTTP i SOCKS, w tym CONNECT
Proxy forward wybiera klient. RFC 9110 §3.7 nazywa je agentem przekazywania komunikatów, który otrzymuje żądania dla niektórych absolutnych URI i stara się je zaspokoić przez HTTP. Dla zwykłych URL http klient wysyła do proxy pełny URL. Dla https zwykły wzorzec jest inny.
RFC 9110 §9.3.6 definiuje CONNECT: klient prosi proxy, żeby zbudowało tunel do host:port i po dowolnym 2xx ograniczyło się do ślepego przekazywania, aż tunel się zamknie. Tunele zwykle potem owija się w TLS. Udany CONNECT nie jest sukcesem aplikacji. Znaczy tylko, że tunel istnieje. Każda inna odpowiedź znaczy, że tunel nie powstał.
SOCKS5 jest starsze i siedzi niżej. RFC 1928 (marzec 1996) opisuje je jako przekładkę między aplikacją a transportem, umownie na TCP 1080. Po negocjacji metody klient wysyła polecenie; CONNECT to X'01'. SOCKS nie parsuje metod HTTP. Przekazuje TCP (i opcjonalnie UDP) do celu, który klient nazwie.
Jeśli biblioteka HTTP mówi HTTPS przez proxy, zwykle robi CONNECT, a potem TLS do origin. Proxy uwierzytelnia tunel, często przez Proxy-Authorization. Ten nagłówek to nie nagłówek Authorization: Bearer, którego oczekuje API modelu. Mieszanie ich to częste źródło „proxy działa w curl, a SDK i tak dostaje 401”.
Jeśli zadanie to tylko „ten proces ma wychodzić innym IP”, zacząć od angielskich list proxy HTTP, proxy HTTPS i proxy SOCKS5. Te strony porównują wyjścia. To nie routery modeli.
03Proxy odwrotne i zwykłe bramy API
Proxy odwrotne, które RFC 9110 w §3.7 też nazywa bramą, przedstawia się klientowi jako origin i przekazuje przychodzące do innego serwera. Klient nie wybrał go jako URL proxy. Klient po prostu otworzył https://api.example.com.
Przewodnik NGINX o reverse-proxy (dostęp 2026-10-15) opisuje mechaniczną pętlę: wysłać żądanie do upstream proxy_pass, pobrać odpowiedź, odesłać ją. Domyślnie NGINX przepisuje Host i Connection. Ten szczegół ma znaczenie dla API, które klucze wirtualnych hostów biorą z Host. Proxy odwrotne może zakończyć TLS na publicznej krawędzi i otworzyć nowe połączenie w głąb. Sesja TLS klienta kończy się wtedy na proxy odwrotnym, nie u sprzedawcy modelu.
Ta warstwa jest właściwym narzędziem do routingu ścieżek (/v1/ kontra /admin/), równoważenia obciążenia, sanityzacji nagłówków i wystawienia jednej nazwy hosta przed kilkoma usługami wewnętrznymi. Może nie wiedzieć, czym jest nazwa modelu. Jeśli tylko przekazuje /v1/chat/completions do jednego upstream, nadal jest bramą API w sensie HTTP, nie bramą LLM.
Nie traktować „postawiliśmy NGINX z przodu” jako dowodu ponowień, budżetów tokenów ani fallback modeli. To dodatkowe cechy, które niektóre produkty dokładają. Strona NGINX, którą czytaliśmy, ich nie twierdzi.
04Bramy LLM: klucze, limity, routing i logi
Brama LLM to usługa aplikacyjna. Klienci wysyłają ciało żądania czatu albo embeddings pod jeden URL. Brama sprawdza wirtualny klucz, może wymuszać budżety, może wybrać dostawcę i model, może logować tokeny, i dopiero wtedy rozmawia ze sprzedawcą — albo z kilkoma.
Strona AI Gateway LiteLLM (HTTP 200 2026-10-15) opisuje self-hosted serwer, który oferuje jeden punkt końcowy zgodny z OpenAI. Udokumentowane zadania obejmują klucze wirtualne z modelami i limitami per klucz, śledzenie wydatków, równoważenie obciążenia, fallback, ponowienia, guardrails i logowanie. Ta sama strona mówi: jeśli klient potrafi użyć API OpenAI, potrafi użyć bramy bez zmiany kodu klienta. To twierdzenie produktowe o kształcie żądania chat completions. To nie dowód, że każdy punkt końcowy, nagłówek i błąd OpenAI mapuje się 1:1. LiteLLM nie instalowaliśmy i nie uruchamialiśmy.
Cloudflare AI Gateway (strona dateModified 2026-04-20, pobrana 2026-10-15) wymienia analitykę, logowanie, cache, limity tempa, ponowienia żądań i fallback modeli jako cechy. Strona dynamic-routing (aktualizacja 2026-10-02) jest precyzyjniejsza o zgodności: trasy dynamiczne przyjmują wyłącznie kształt żądania OpenAI chat completions; Anthropic Messages zwracają HTTP 400. To zdanie jest powodem, dla którego „OpenAI-compatible” musi zostać wąskie. Cloudflare nie wołaliśmy i nie wykonywaliśmy ponowień ani fallback. Jeśli dokument bramy wymienia te cechy, traktować je jako wyłącznie źródłowe, dopóki nie odpalicie ich wobec tego produktu.
Lokalnie zbudowaliśmy malutki router, który nie jest tymi produktami. Przyjmował Authorization: Bearer local-demo-key-not-a-provider-secret, mapował fixture-alpha i fixture-bravo na dwa ładunki atrapy, zwracał 401 bez ważnego lokalnego tokenu i zwracał 400 dla nieznanego modelu. To wystarcza, żeby pokazać, że płaszczyzna sterowania siedzi w HTTP JSON, nie w CONNECT.
05Śledzić żądanie: TLS, Host i kto może czytać ciało
Przejść jedno POST /v1/chat/completions przez oba projekty.
Ścieżka forward użyta w przebiegu na loopback: klient otworzył TCP do 127.0.0.1:54318, wysłał CONNECT 127.0.0.1:54316 HTTP/1.1, dostał 200 Connection Established, a potem dokończył TLS wobec certyfikatu origin. Dopiero po TLS wysłał ciało JSON i nagłówek Bearer przeznaczony dla origin. Proces CONNECT zapisał cel 127.0.0.1:54316. Nie zobaczył JSON atrapy ani tokenu Bearer: lista fragmentów ciała HTTP zaobserwowanych na tunelu była pusta. TLS kończył się na atrapie origin. Origin odpowiedział HTTP 200 z kontrolowaną atrapą.
Ścieżka bramy: klient otworzył TCP do 127.0.0.1:54317 bez CONNECT. TLS nie był użyty na tym przeskoku w demo (zwykły HTTP na loopback). Brama odczytała pole JSON model i lokalny token Bearer zanim dla tego żądania istniał jakikolwiek origin. Brakujące albo złe lokalne auth nigdy nie doszło do atrapy modelu jako udana trasa; oba dały HTTP 401 z invalid_local_gateway_auth. Nieznany model dał HTTP 400 z unsupported_model_or_route po udanym auth. Transport był w górze. Aplikacja odmówiła zadania.
W produkcyjnym HTTPS brama LLM niemal zawsze kończy TLS. Musi, jeśli ma parsować JSON, stosować budżet albo wybierać model. Proxy forward CONNECT, które nie jest middleboxem TLS, nie kończy tego TLS origin. Jeśli ktoś włącza inspekcję HTTPS na korporacyjnym proxy, to inne wdrożenie: proxy staje się klientem TLS wobec origin i serwerem TLS wobec was. Nie zakładać inspekcji tylko dlatego, że CONNECT się udał.
Przegląd API OpenAI (pobrany 2026-10-15; żądany platform.openai.com/docs/api-reference przekierował tutaj) dokumentuje dane Bearer na żądaniu origin. Traktuje x-request-id jako identyfikator korelacji żądania, osobny od nagłówków limitu tempa takich jak x-ratelimit-limit-requests. Te pola należą do rozmowy dostawcy. Brama może dodać własne identyfikatory żądań. Proxy forward zwykle nie.
06Zgodność to kształt klienta, nie całe API
SDK często pozwalają ustawić base_url i nadal używać chat.completions.create. Sprzedawcy nazywają to OpenAI-compatible. Uwaga Cloudflare o dynamic-routing jest ostrożnością: nawet wewnątrz jednego sprzedawcy ścieżka zgodności może przyjąć tylko jeden kształt żądania i 400 inny.
Zgodny punkt końcowy nadal może różnić się uwierzytelnianiem (klucz wirtualny kontra klucz dostawcy), nazwami modeli (gpt-4.1 kontra azure/gpt-4.1 kontra alias bramy), układami zdarzeń streamingu, polami tool-call, uploadami plików, gniazdami realtime i API administracji. Własny przegląd OpenAI traktuje Responses, Realtime i Administration jako osobne powierzchnie. Skopiowanie /v1/chat/completions nie kopiuje całego tego drzewa.
Brama na loopback zwracała JSON, który wygląda jak chat completion (choices[0].message). To była atrapa. Nie czyni demo „OpenAI compatible” w żadnym produktowym sensie.
07Trzy różne rodzaje „zadziałało”
Te trzy wyniki trzymać osobno, gdy czytacie logi.
| Warstwa | Przykład sukcesu | Przykład awarii | Czego to nie dowodzi |
|---|---|---|---|
| Transport / tunel | CONNECT 200 Connection Established; odpowiedź SOCKS CONNECT | Proxy 403, timeout, błąd handshake TLS | Że model przyjął prompt albo klucz |
| HTTP do następnego przeskoku | 200 albo nawet 401/400 z ciałem JSON | Pusta odpowiedź, RST, HTTP 502 od proxy odwrotnego | Że JSON jest wynikiem modelu |
| Aplikacja / trasa modelu | Brama mapuje fixture-alpha na atrapę alpha; dostawca zwraca completion | Brama 400 nieobsługiwany model; dostawca 401 niepoprawny klucz API; odmowa safety modelu wewnątrz HTTP 200 | Że inne warstwy są zdrowe, albo że drugi sprzedawca zachowałby się tak samo |
2026-10-15 lokalny skrypt zapisał sześć przypadków i szesnaście asercji, wszystkie zaliczone, przy Pythonie 3.9.6 i LibreSSL 3.3.6:
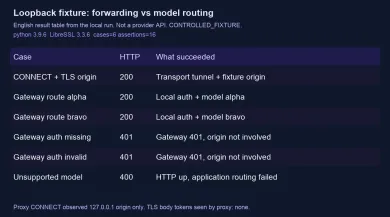
Przekazywanie dało origin HTTP 200. Routing bramy dał dwie różne trasy atrapy. Awarie auth zostały na bramie z 401. Nieobsługiwany model został na bramie z 400. Ponowienia, streaming i fallback nie były wykonywane i nie są twierdzone.
Strona Jaki jest mój adres IP zgłasza adres, który doszedł do tej strony z waszej przeglądarki. Sprawdzanie proxy to sonda po stronie serwera punktu końcowego, który podacie. Żadne z nich nie pokazuje trasy, którą weźmie proces SDK Pythona, i żadne nie ustala uprawnienia do API LLM. Sprawdzanie nie dowodzi, że sprzedawca modelu przyjmie IP, że klucz jest ważny, ani że wolno wam użyć danego konta.
08Wybrać warstwę, która pasuje do zadania
Użyć proxy forward HTTP CONNECT albo SOCKS5, gdy problemem jest skąd wychodzi sesja TCP — korporacyjny egress, laptop deweloperski, który nie dosięga sprzedawcy, albo opublikowane wyjście datacenter albo mobilne. Skonfigurować ustawienia proxy SDK (albo HTTPS_PROXY) i zostawić klucz API dostawcy na żądaniu, które zobaczy origin. Nie oczekiwać, że proxy będzie wybierać modele.
Użyć proxy odwrotnego albo zwykłej bramy API, gdy problemem jest jedna nazwa hosta, wiele usług wewnętrznych, TLS na krawędzi albo polityka nagłówków. Skierować DNS na tę bramę. Nie oczekiwać, że zna wydatek tokenów, chyba że sami to dodaliście.
Użyć bramy LLM, gdy problemem jest wielu klientów, wiele modeli, jedna polityka. Wydawać klucze wirtualne, ustawiać budżety, logować prompty jeśli polityka na to pozwala, i mapować aliasy na modele dostawcy. Klucze dostawcy trzymać na hoście bramy, nie na każdym laptopie. Czytać aktualne uwagi o zgodności sprzedawcy; nie zakładać ponowień ani fallback. Jeśli macie tylko jeden proces Pythona i nie macie wspólnej polityki, brama może być zbędnymi ruchomymi częściami — własne dokumenty LiteLLM dzielą „gateway versus SDK” właśnie na tej osi.
Lista kontrolna przed zakupem albo budową:
- Zapisać awarię, którą naprawdę zobaczyliście: TCP, TLS, status HTTP albo błąd JSON.
- Nazwać, kto kończy TLS.
- Nazwać, który sekret jest dla tunelu, który dla bramy, a który dla dostawcy.
- Nazwać ciąg modelu, który wysyła klient, i ciąg, którego oczekuje dostawca.
- Potwierdzić, czy streaming, ponowienia i fallback są udokumentowane oraz przetestowane na tym produkcie. Jeśli ich nie odpaliliście, nie twierdzić ich.
- Potwierdzić kształt żądania klienta (chat completions kontra inny schemat).
- Jeśli potrzebowaliście tylko innego IP wyjścia, zatrzymać się na proxy forward i pominąć router modeli.
Ponumerowana tabela i rysunek WebP powyżej pochodzą z osobnego laboratorium CONNECT+TLS na loopback z tego samego dnia. To laboratorium to rzeczywiste przekazywanie wybrane przez klienta: HTTP CONNECT, potem TLS do origin. To nie przepis copy-paste poniżej.
Ten publiczny przepis to zwykły HTTP wyłącznie na 127.0.0.1. Nie otwiera tunelu CONNECT, nie używa TLS i nie woła sprzedawcy modelu. Jego przeskok Forward zawsze postuje na stały origin_port, a klient używa ścieżki origin-form (/v1/chat/completions). W sensie RFC 9110 to przekazywanie w stylu odwrotnym, ze stałym upstream, nie proxy forward HTTP wybrane przez klienta. Porównać ten przeskok z aplikacyjnym routerem modeli w tym samym skrypcie. Nie czytać forward_http w oczekiwanym wyjściu jako dowodu proxy forward wybranego przez klienta.
Setup: Python 3.9 albo nowszy. Wyłącznie biblioteka standardowa. Bez pakietów. Bez kluczy API.
- Zapisać poniższy skrypt jako forwarding_vs_routing.py w dowolnym katalogu, który posiadacie.
- Uruchomić: python3 forwarding_vs_routing.py
- Wasze stdout powinno zgadzać się z oczekiwanym wyjściem po skrypcie.
#!/usr/bin/env python3
"""Plain-HTTP loopback demo: forwarding vs model routing. Stdlib only."""
from __future__ import annotations

import json
import threading
from http.client import HTTPConnection
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

BIND = "127.0.0.1"
KEY = "***"
LABEL = "CONTROLLED_FIXTURE_NOT_A_PROVIDER"
TIMEOUT = 5


class Origin(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"

    def log_message(self, *_args):
        return

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        self.rfile.read(n)
        body = json.dumps(
            {
                "label": LABEL,
                "origin": "loopback-http-origin",
                "choices": [
                    {
                        "index": 0,
                        "message": {
                            "role": "assistant",
                            "content": "FIXTURE: forwarded origin",
                        },
                    }
                ],
            }
        ).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(body)


class Gateway(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    ROUTES = {
        "fixture-alpha": {"label": LABEL, "route": "alpha"},
        "fixture-bravo": {"label": LABEL, "route": "bravo"},
    }

    def log_message(self, *_args):
        return

    def _send(self, code, obj):
        raw = json.dumps(obj).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(raw)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(raw)

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        raw = self.rfile.read(n)
        auth = self.headers.get("Authorization") or ""
        try:
            model = json.loads(raw.decode() or "{}").get("model")
        except json.JSONDecodeError:
            model = None
        if auth != "Bearer " + KEY:
            self._send(401, {"error": "invalid_local_gateway_auth", "label": LABEL})
            return
        route = self.ROUTES.get(model)
        if route is None:
            self._send(
                400,
                {
                    "error": "unsupported_model_or_route",
                    "requested": model,
                    "label": LABEL,
                },
            )
            return
        self._send(200, route)


class Forward(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    origin_port = 0

    def log_message(self, *_args):
        return

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        body = self.rfile.read(n)
        upstream = HTTPConnection(BIND, self.origin_port, timeout=TIMEOUT)
        try:
            skip = {"host", "proxy-connection"}
            headers = {k: v for k, v in self.headers.items() if k.lower() not in skip}
            upstream.request("POST", self.path, body=body, headers=headers)
            resp = upstream.getresponse()
            data = resp.read()
            status = resp.status
            ctype = resp.getheader("Content-Type") or "application/json"
        finally:
            upstream.close()
        self.send_response(status)
        self.send_header("Content-Type", ctype)
        self.send_header("Content-Length", str(len(data)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(data)


def start(handler):
    httpd = ThreadingHTTPServer((BIND, 0), handler)
    httpd.daemon_threads = False
    httpd.timeout = 0.3
    thread = threading.Thread(
        target=httpd.serve_forever,
        name="srv-%s" % httpd.server_address[1],
        daemon=False,
    )
    thread.start()
    return httpd, thread


def post(port, path, payload, headers):
    conn = HTTPConnection(BIND, port, timeout=TIMEOUT)
    try:
        raw = json.dumps(payload).encode()
        hdrs = {"Content-Type": "application/json"}
        hdrs.update(headers)
        conn.request("POST", path, body=raw, headers=hdrs)
        resp = conn.getresponse()
        return resp.status, json.loads(resp.read().decode())
    finally:
        conn.close()


def main():
    origin_httpd = gw_httpd = fwd_httpd = None
    threads = []
    try:
        origin_httpd, origin_thread = start(Origin)
        threads.append(origin_thread)
        Forward.origin_port = origin_httpd.server_address[1]
        fwd_httpd, fwd_thread = start(Forward)
        threads.append(fwd_thread)
        gw_httpd, gw_thread = start(Gateway)
        threads.append(gw_thread)

        ping = {
            "model": "ignored-by-forward",
            "messages": [{"role": "user", "content": "ping"}],
        }
        rows = []
        status, body = post(
            fwd_httpd.server_address[1],
            "/v1/chat/completions",
            ping,
            {"Authorization": "***"},
        )
        rows.append(("forward_http", status, body.get("origin") or body.get("error")))
        assert status == 200
        assert body.get("label") == LABEL
        assert body.get("origin") == "loopback-http-origin"

        gw = gw_httpd.server_address[1]
        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_route_alpha", status, body.get("route") or body.get("error")))
        assert status == 200 and body.get("route") == "alpha"

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-bravo", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_route_bravo", status, body.get("route") or body.get("error")))
        assert status == 200 and body.get("route") == "bravo"

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {},
        )
        rows.append(("gateway_auth_missing", status, body.get("error")))
        assert status == 401

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {"Authorization": "***"},
        )
        rows.append(("gateway_auth_invalid", status, body.get("error")))
        assert status == 401

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "no-such-model", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_unsupported_model", status, body.get("error")))
        assert status == 400

        print("CONTROLLED_FIXTURE public recipe — not a provider call, not TLS")
        for name, status, extra in rows:
            print("%s HTTP %s %s" % (name, status, extra))
        print("assertions=6 ok")
        return 0
    finally:
        for httpd in (origin_httpd, gw_httpd, fwd_httpd):
            if httpd is not None:
                httpd.shutdown()
                httpd.server_close()
        for thread in threads:
            thread.join(timeout=TIMEOUT)


if __name__ == "__main__":
    raise SystemExit(main())
Oczekiwane wyjście:
CONTROLLED_FIXTURE public recipe — not a provider call, not TLS
forward_http HTTP 200 loopback-http-origin
gateway_route_alpha HTTP 200 alpha
gateway_route_bravo HTTP 200 bravo
gateway_auth_missing HTTP 401 invalid_local_gateway_auth
gateway_auth_invalid HTTP 401 invalid_local_gateway_auth
gateway_unsupported_model HTTP 400 unsupported_model_or_route
assertions=6 ok
Wiersz forward_http to to przekazywanie ze stałym upstream. Laboratorium CONNECT+TLS w tabeli i WebP pozostaje dowodem przekazywania.
Czy proxy sieciowe zmienia klucz API modelu, który trzeba wysłać?
Czy HTTP CONNECT czyta ciało JSON TLS?
Dlaczego uwierzytelnianie bramy różni się od uwierzytelniania dostawcy?
Co „OpenAI-compatible” naprawdę znaczy?
Czy SOCKS5 może zastąpić HTTP CONNECT dla HTTPS API modeli?
Czy sprawdzanie proxy dowodzi, że API LLM przyjmie ten IP?
Czy wszystkie bramy LLM ponawiają, robią fallback i streamują tak samo?
Powiązane artykuły
Czym są proxy rezydenckie i jak działają
Proxy rezydenckie wychodzą przez adresy konsumenckich ISP. Tu jest, jak działają pule, sesje sticky, co widzą witryny i o co pytać dostawcę przed zakupem.
4 minNajlepsze proxy do web scrapingu w 2026: lista kontrolna kupującego
Zakup proxy do scrapingu w 2026 zaczyna się od celu, nie od sprzedawcy. Ta lista kontrolna obejmuje pochodzenie, sesję, geo, rozliczenie i żywy test, zanim przeskalujecie.
5 minSticky a rotacyjne proxy: sterowanie sesją wyjaśnione
Sticky a rotacyjne proxy: jak działa rotacja na żądanie i na timerze, kiedy sesja sticky bije nowy IP, jak ciasteczka reagują na zmianę adresu i jak samodzielnie przetestować identyfikator sesji.
9 min
