AI proxy e gateway LLM: qual è la differenza?
Distinguere l'inoltro di rete, un API gateway e il routing dei modelli, così si sceglie il livello che corrisponde al lavoro.
Si dice «AI proxy» per tre scatole diverse: un forwarder di rete, un gateway API reverse e un router di modelli. Questa guida è per gli sviluppatori che devono scegliere un livello senza mescolare i lavori. Non vende indirizzi IP, non distribuisce chiavi e non pretende che un proxy cambi l'idoneità di account o di geografia.
01Che cosa di solito si intende per «AI proxy»
La frase non è uno standard. RFC 9110 (HTTP Semantics, giugno 2022, STD 97) divide già gli intermediari in un proxy, un gateway e un tunnel, e avverte che un processo può cambiare ruolo per richiesta. Nel copy di prodotto la stessa parola viene riusata per un'altra cosa ancora: un processo che accetta un body JSON in stile OpenAI e sceglie un modello.
Quei tre lavori sembrano simili in un diagramma perché ciascuno sta tra il suo client e qualcosa a monte. Falliscono in posti diversi. Un forward proxy può aprire un tunnel TCP e lasciarla comunque con un 401 del fornitore. Un gateway LLM può restituire HTTP 200 con un errore JSON su un modello sconosciuto mentre il percorso di rete era a posto. Se si debugga il livello sbagliato, si ruota il segreto sbagliato.
Un'esecuzione locale delimitata il 2026-10-15 ha reso concreto quello spacco. Un proxy HTTP CONNECT in loopback ha inoltrato il TLS a un'origine fixture. Un processo loopback distinto ha instradato fixture-alpha contro fixture-bravo dopo un controllo Bearer locale. Niente è uscito da 127.0.0.1. Niente ha chiamato un'API di modello a pagamento. Il JSON della fixture è etichettato CONTROLLED_FIXTURE_NOT_A_PROVIDER di proposito.
Quando un vendor chiama un prodotto «AI proxy», leggere quale di quei lavori implementa davvero. Non assumere che esistano retry, streaming o fallback perché la parola gateway compare in homepage.
02Forward proxy HTTP e SOCKS, compreso CONNECT
Un forward proxy è scelto dal client. RFC 9110 §3.7 lo chiama un agente di inoltro messaggi che riceve richieste per alcuni URI assoluti e cerca di soddisfarle attraverso HTTP. Per gli URL http ordinari il client invia l'URL completo al proxy. Per https il pattern usuale è diverso.
RFC 9110 §9.3.6 definisce CONNECT: il client chiede al proxy di costruire un tunnel verso host:port e, dopo qualsiasi 2xx, di limitarsi a un inoltro cieco finché il tunnel non si chiude. I tunnel sono di solito avvolti in TLS dopo di quello. Un CONNECT riuscito non è un successo applicativo. Significa solo che il tunnel esiste. Qualsiasi altra risposta significa che il tunnel non è stato formato.
SOCKS5 è più vecchio e sta più in basso. RFC 1928 (marzo 1996) lo descrive come uno shim tra applicazione e trasporto, convenzionalmente su TCP 1080. Dopo la negoziazione del metodo il client invia un comando; CONNECT è X'01'. SOCKS non analizza i metodi HTTP. Inoltra TCP (e opzionalmente UDP) a una destinazione che il client nomina.
Se la libreria HTTP parla HTTPS attraverso un proxy, di solito sta facendo CONNECT, poi TLS verso l'origine. Il proxy autentica il tunnel, spesso con Proxy-Authorization. Quell'header non è l'header Authorization: Bearer che l'API del modello si aspetta. Mescolarli è una fonte comune di «il proxy funziona in curl ma l'SDK dà ancora 401».
Se il lavoro è solo «questo processo deve uscire da un altro IP», partire dagli elenchi di proxy HTTP, proxy HTTPS e proxy SOCKS5. Quelle pagine confrontano le uscite. Non sono router di modelli.
03Reverse proxy e API gateway ordinari
Un reverse proxy, che RFC 9110 chiama anche gateway in §3.7, si presenta al client come l'origine e inoltra in ingresso a un altro server. Il client non l'ha scelto come URL di proxy. Il client ha solo aperto https://api.example.com.
La guida reverse-proxy di NGINX (consultata il 2026-10-15) descrive il ciclo meccanico: inviare la richiesta a un upstream proxy_pass, prendere la risposta, rimandarla indietro. Di default NGINX riscrive Host e Connection. Quel dettaglio conta per le API che agganciano i virtual host a Host. Un reverse proxy può terminare il TLS sul bordo pubblico e aprire una nuova connessione all'interno. La sessione TLS del client finisce allora al reverse proxy, non al vendor del modello.
Questo livello è lo strumento giusto per il routing di path (/v1/ contro /admin/), il load balancing, la sanificazione degli header, e l'esposizione di un hostname davanti a diversi servizi interni. Può non sapere che cosa è un nome di modello. Se inoltra solo /v1/chat/completions a un unico upstream, è comunque un API gateway nel senso HTTP, non un gateway LLM.
Non trattare «abbiamo messo NGINX davanti» come prova di retry, budget di token o fallback di modello. Sono funzioni extra che alcuni prodotti aggiungono. La pagina NGINX che abbiamo letto non le pretende.
04Gateway LLM: chiavi, limiti, routing e log
Un gateway LLM è un servizio applicativo. I client inviano un body di chat o embeddings a un URL. Il gateway controlla una chiave virtuale, può imporre budget, può scegliere un fornitore e un modello, può registrare i token, e solo allora parla a un vendor — o a diversi vendor.
La pagina AI Gateway di LiteLLM (HTTP 200 il 2026-10-15) descrive un server self-hosted che offre un endpoint compatibile OpenAI. I lavori documentati includono chiavi virtuali con modelli e rate limit per chiave, spend tracking, load balancing, fallback, retry, guardrail e logging. La stessa pagina dice: se un client può usare l'API OpenAI, può usare il gateway senza cambiare il codice client. È una pretesa di prodotto sulla forma della richiesta chat completions. Non è una prova che ogni endpoint, header ed errore OpenAI mappi 1:1. Non abbiamo installato né eseguito LiteLLM.
Cloudflare AI Gateway (dateModified della pagina 2026-04-20, recuperata il 2026-10-15) elenca analytics, logging, caching, rate limiting, retry delle richieste e fallback di modello come funzioni. La pagina dynamic-routing (aggiornata il 2026-10-02) è più precisa sulla compatibilità: le route dinamiche accettano solo la forma della richiesta chat completions di OpenAI; Anthropic Messages restituiscono HTTP 400. Quella frase è il motivo per cui «compatibile OpenAI» deve restare stretto. Non abbiamo chiamato Cloudflare e non abbiamo eseguito retry o fallback. Se un documento di gateway elenca quelle funzioni, trattarle come solo-fonte finché non le si esegue contro quel prodotto.
In locale abbiamo costruito un router minuscolo che non è quei prodotti. Accettava Authorization: Bearer local-demo-key-not-a-provider-secret, mappava fixture-alpha e fixture-bravo su due payload fixture, restituiva 401 senza un token locale valido, e restituiva 400 per un modello sconosciuto. Basta a mostrare che il piano di controllo sta nell'HTTP JSON, non in CONNECT.
05Seguire una richiesta: TLS, Host, e chi può leggere il body
Seguire un POST /v1/chat/completions attraverso entrambi gli schemi.
Percorso forward usato nell'esecuzione loopback: il client ha aperto TCP verso 127.0.0.1:54318, ha inviato CONNECT 127.0.0.1:54316 HTTP/1.1, ha ricevuto 200 Connection Established, poi ha completato il TLS verso il certificato dell'origine. Solo dopo il TLS ha inviato il body JSON e un header Bearer destinato all'origine. Il processo CONNECT ha registrato la destinazione 127.0.0.1:54316. Non ha visto il JSON della fixture né il token Bearer: l'elenco di frammenti di body HTTP osservati sul tunnel era vuoto. Il TLS è finito all'origine fixture. L'origine ha risposto HTTP 200 con la fixture controllata.
Percorso gateway: il client ha aperto TCP verso 127.0.0.1:54317 senza CONNECT. Il TLS non è stato usato su quell'hop nella demo (HTTP in chiaro su loopback). Il gateway ha letto il campo JSON model e il token Bearer locale prima che esistesse un'origine per quella richiesta. Auth locale mancante o sbagliata non ha mai raggiunto una fixture di modello come route riuscita; entrambe hanno prodotto HTTP 401 con invalid_local_gateway_auth. Un modello sconosciuto ha prodotto HTTP 400 con unsupported_model_or_route dopo che l'auth era riuscita. Il trasporto era su. L'applicazione ha rifiutato il lavoro.
In HTTPS di produzione, un gateway LLM termina quasi sempre il TLS. Deve, se sta per analizzare JSON, applicare un budget, o scegliere un modello. Un forward proxy CONNECT che non è un middlebox TLS non termina quel TLS di origine. Se qualcuno abilita l'ispezione HTTPS su un proxy aziendale, è un deployment diverso: il proxy diventa un client TLS verso l'origine e un server TLS verso di lei. Non assumere l'ispezione solo perché CONNECT è riuscito.
La panoramica API di OpenAI (recuperata il 2026-10-15; il richiesto platform.openai.com/docs/api-reference ha reindirizzato qui) documenta le credenziali Bearer sulla richiesta di origine. Tratta x-request-id come identificatore di correlazione della richiesta, distinto dagli header di rate-limit come x-ratelimit-limit-requests. Quei campi appartengono alla conversazione del fornitore. Un gateway può aggiungere i propri request ID. Un forward proxy di solito no.
06La compatibilità è una forma client, non l'intera API
Gli SDK spesso lasciano impostare base_url e continuare a usare chat.completions.create. I vendor lo chiamano compatibile OpenAI. La nota dynamic-routing di Cloudflare è la cautela: anche dentro un solo vendor, un percorso di compatibilità può accettare una sola forma di richiesta e dare 400 a un'altra.
Un endpoint compatibile può comunque differire in autenticazione (chiave virtuale contro chiave del fornitore), nomi di modello (gpt-4.1 contro azure/gpt-4.1 contro un alias di gateway), layout degli eventi di streaming, campi tool-call, upload di file, socket realtime e API di amministrazione. La panoramica di OpenAI stessa tratta Responses, Realtime e Administration come superfici distinte. Copiare /v1/chat/completions non copia quell'intero albero.
Il gateway loopback ha restituito JSON che sembra una chat completion (choices[0].message). Era una fixture. Non rende la demo «compatibile OpenAI» in nessun senso di prodotto.
07Tre tipi diversi di «ha funzionato»
Tenere questi tre esiti distinti quando si leggono i log.
| Livello | Esempio di successo | Esempio di fallimento | Che cosa non dimostra |
|---|---|---|---|
| Trasporto / tunnel | CONNECT 200 Connection Established; risposta SOCKS CONNECT | Proxy 403, timeout, errore di handshake TLS | Il modello ha accettato il prompt o la chiave |
| HTTP verso l'hop successivo | 200 o anche 401/400 con un body JSON | Risposta vuota, RST, HTTP 502 da un reverse proxy | Il JSON è un risultato di modello |
| Applicazione / route di modello | Il gateway mappa fixture-alpha sulla fixture alpha; il fornitore restituisce una completion | Gateway 400 modello non supportato; fornitore 401 API key non valida; rifiuto di safety del modello dentro HTTP 200 | Gli altri livelli sono sani, o che un secondo vendor si comporterebbe allo stesso modo |
Il 2026-10-15 lo script locale ha registrato sei casi e sedici asserzioni, tutte passate, con Python 3.9.6 e LibreSSL 3.3.6:
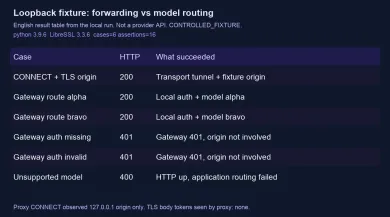
L'inoltro ha prodotto HTTP 200 dell'origine. Il routing del gateway ha prodotto due route fixture diverse. I fallimenti di auth sono restati al gateway con 401. Il modello non supportato è restato al gateway con 400. Retry, streaming e fallback non sono stati eseguiti e non sono pretesi.
La pagina Il mio IP riporta l'indirizzo che ha raggiunto quella pagina dal suo browser. Il controllo proxy è una sonda lato server di un endpoint che lei fornisce. Nessuno dei due mostra il percorso che prenderà un processo SDK Python, e nessuno dei due stabilisce l'idoneità all'API LLM. Il controllo non dimostra che un vendor di modelli accetterà un IP, che una chiave è valida, o che le è permesso usare un dato account.
08Scegliere il livello che corrisponde al lavoro
Usare un forward proxy HTTP CONNECT o SOCKS5 quando il problema è dove esce la sessione TCP — un egress aziendale, un portatile di sviluppo che non raggiunge un vendor, o un'uscita pubblicata datacenter o mobile. Configurare le impostazioni proxy dell'SDK (o HTTPS_PROXY) e tenere la chiave API del fornitore sulla richiesta che l'origine vedrà. Non aspettarsi che il proxy scelga i modelli.
Usare un reverse proxy o un API gateway generico quando il problema è un hostname, tanti servizi interni, TLS al bordo, o policy sugli header. Puntare il DNS a quel gateway. Non aspettarsi che conosca lo spend di token a meno che non lo abbia aggiunto lei.
Usare un gateway LLM quando il problema è tanti client, tanti modelli, una policy. Emettere chiavi virtuali, impostare budget, registrare i prompt se la sua policy lo consente, e mappare alias sui modelli del fornitore. Tenere le chiavi del fornitore sull'host del gateway, non in ogni portatile. Leggere le note di compatibilità attuali del vendor; non assumere retry o fallback. Se ha un solo processo Python e nessuna policy condivisa, un gateway può essere parti in movimento di troppo — la documentazione di LiteLLM stessa spezza «gateway contro SDK» su quell'asse.
Lista di controllo prima di comprare o costruire:
- Scrivere il fallimento che ha visto davvero: TCP, TLS, stato HTTP, o errore JSON.
- Nominare chi termina il TLS.
- Nominare quale segreto è per il tunnel, quale per il gateway, e quale per il fornitore.
- Nominare la stringa di modello che il client invia e la stringa che il fornitore si aspetta.
- Confermare se streaming, retry e fallback sono documentati e testati su quel prodotto. Se non li ha eseguiti, non pretenderli.
- Confermare la forma della richiesta client (chat completions contro un altro schema).
- Se serviva solo un IP di uscita diverso, fermarsi al forward proxy e saltare il router di modelli.
La tabella numerata e la figura WebP sopra vengono da un laboratorio loopback CONNECT+TLS distinto, eseguito lo stesso giorno. Quel laboratorio è inoltro vero scelto dal client: HTTP CONNECT, poi TLS verso l'origine. Non è la ricetta copia-incolla sotto.
Questa ricetta pubblica è HTTP in chiaro solo su 127.0.0.1. Non apre un tunnel CONNECT, non usa TLS, e non chiama un vendor di modelli. Il suo hop Forward fa sempre POST a un origin_port fisso, e il client usa un path in origin-form (/v1/chat/completions). Nel senso di RFC 9110 è un pass-through reverse-style a upstream fisso, non un forward proxy HTTP scelto dal client. Confrontare quell'hop con il router applicativo di modelli nello stesso script. Non leggere forward_http nell'output atteso come prova di un forward proxy scelto dal client.
Setup: Python 3.9 o più recente. Solo libreria standard. Nessun pacchetto. Nessuna chiave API.
- Salvare lo script seguente come forwarding_vs_routing.py in una directory di sua proprietà.
- Eseguire: python3 forwarding_vs_routing.py
- Lo stdout dovrebbe coincidere con l'output atteso dopo lo script.
#!/usr/bin/env python3
"""Plain-HTTP loopback demo: forwarding vs model routing. Stdlib only."""
from __future__ import annotations

import json
import threading
from http.client import HTTPConnection
from http.server import BaseHTTPRequestHandler, ThreadingHTTPServer

BIND = "127.0.0.1"
KEY = "***"
LABEL = "CONTROLLED_FIXTURE_NOT_A_PROVIDER"
TIMEOUT = 5


class Origin(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"

    def log_message(self, *_args):
        return

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        self.rfile.read(n)
        body = json.dumps(
            {
                "label": LABEL,
                "origin": "loopback-http-origin",
                "choices": [
                    {
                        "index": 0,
                        "message": {
                            "role": "assistant",
                            "content": "FIXTURE: forwarded origin",
                        },
                    }
                ],
            }
        ).encode()
        self.send_response(200)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(body)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(body)


class Gateway(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    ROUTES = {
        "fixture-alpha": {"label": LABEL, "route": "alpha"},
        "fixture-bravo": {"label": LABEL, "route": "bravo"},
    }

    def log_message(self, *_args):
        return

    def _send(self, code, obj):
        raw = json.dumps(obj).encode()
        self.send_response(code)
        self.send_header("Content-Type", "application/json")
        self.send_header("Content-Length", str(len(raw)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(raw)

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        raw = self.rfile.read(n)
        auth = self.headers.get("Authorization") or ""
        try:
            model = json.loads(raw.decode() or "{}").get("model")
        except json.JSONDecodeError:
            model = None
        if auth != "Bearer " + KEY:
            self._send(401, {"error": "invalid_local_gateway_auth", "label": LABEL})
            return
        route = self.ROUTES.get(model)
        if route is None:
            self._send(
                400,
                {
                    "error": "unsupported_model_or_route",
                    "requested": model,
                    "label": LABEL,
                },
            )
            return
        self._send(200, route)


class Forward(BaseHTTPRequestHandler):
    protocol_version = "HTTP/1.1"
    origin_port = 0

    def log_message(self, *_args):
        return

    def do_POST(self):
        n = int(self.headers.get("Content-Length") or 0)
        body = self.rfile.read(n)
        upstream = HTTPConnection(BIND, self.origin_port, timeout=TIMEOUT)
        try:
            skip = {"host", "proxy-connection"}
            headers = {k: v for k, v in self.headers.items() if k.lower() not in skip}
            upstream.request("POST", self.path, body=body, headers=headers)
            resp = upstream.getresponse()
            data = resp.read()
            status = resp.status
            ctype = resp.getheader("Content-Type") or "application/json"
        finally:
            upstream.close()
        self.send_response(status)
        self.send_header("Content-Type", ctype)
        self.send_header("Content-Length", str(len(data)))
        self.send_header("Connection", "close")
        self.end_headers()
        self.wfile.write(data)


def start(handler):
    httpd = ThreadingHTTPServer((BIND, 0), handler)
    httpd.daemon_threads = False
    httpd.timeout = 0.3
    thread = threading.Thread(
        target=httpd.serve_forever,
        name="srv-%s" % httpd.server_address[1],
        daemon=False,
    )
    thread.start()
    return httpd, thread


def post(port, path, payload, headers):
    conn = HTTPConnection(BIND, port, timeout=TIMEOUT)
    try:
        raw = json.dumps(payload).encode()
        hdrs = {"Content-Type": "application/json"}
        hdrs.update(headers)
        conn.request("POST", path, body=raw, headers=hdrs)
        resp = conn.getresponse()
        return resp.status, json.loads(resp.read().decode())
    finally:
        conn.close()


def main():
    origin_httpd = gw_httpd = fwd_httpd = None
    threads = []
    try:
        origin_httpd, origin_thread = start(Origin)
        threads.append(origin_thread)
        Forward.origin_port = origin_httpd.server_address[1]
        fwd_httpd, fwd_thread = start(Forward)
        threads.append(fwd_thread)
        gw_httpd, gw_thread = start(Gateway)
        threads.append(gw_thread)

        ping = {
            "model": "ignored-by-forward",
            "messages": [{"role": "user", "content": "ping"}],
        }
        rows = []
        status, body = post(
            fwd_httpd.server_address[1],
            "/v1/chat/completions",
            ping,
            {"Authorization": "***"},
        )
        rows.append(("forward_http", status, body.get("origin") or body.get("error")))
        assert status == 200
        assert body.get("label") == LABEL
        assert body.get("origin") == "loopback-http-origin"

        gw = gw_httpd.server_address[1]
        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_route_alpha", status, body.get("route") or body.get("error")))
        assert status == 200 and body.get("route") == "alpha"

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-bravo", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_route_bravo", status, body.get("route") or body.get("error")))
        assert status == 200 and body.get("route") == "bravo"

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {},
        )
        rows.append(("gateway_auth_missing", status, body.get("error")))
        assert status == 401

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "fixture-alpha", "messages": []},
            {"Authorization": "***"},
        )
        rows.append(("gateway_auth_invalid", status, body.get("error")))
        assert status == 401

        status, body = post(
            gw,
            "/v1/chat/completions",
            {"model": "no-such-model", "messages": []},
            {"Authorization": "Bearer " + KEY},
        )
        rows.append(("gateway_unsupported_model", status, body.get("error")))
        assert status == 400

        print("CONTROLLED_FIXTURE public recipe — not a provider call, not TLS")
        for name, status, extra in rows:
            print("%s HTTP %s %s" % (name, status, extra))
        print("assertions=6 ok")
        return 0
    finally:
        for httpd in (origin_httpd, gw_httpd, fwd_httpd):
            if httpd is not None:
                httpd.shutdown()
                httpd.server_close()
        for thread in threads:
            thread.join(timeout=TIMEOUT)


if __name__ == "__main__":
    raise SystemExit(main())
Output atteso:
CONTROLLED_FIXTURE public recipe — not a provider call, not TLS
forward_http HTTP 200 loopback-http-origin
gateway_route_alpha HTTP 200 alpha
gateway_route_bravo HTTP 200 bravo
gateway_auth_missing HTTP 401 invalid_local_gateway_auth
gateway_auth_invalid HTTP 401 invalid_local_gateway_auth
gateway_unsupported_model HTTP 400 unsupported_model_or_route
assertions=6 ok
La riga forward_http è quel pass-through a upstream fisso. Il laboratorio CONNECT+TLS nella tabella e nel WebP resta la prova dell'inoltro.
Un proxy di rete cambia la chiave API del modello che devo inviare?
HTTP CONNECT legge il body JSON del TLS?
Perché l'auth del gateway è diversa dall'auth del fornitore?
Che cosa significa davvero «compatibile OpenAI»?
SOCKS5 può sostituire HTTP CONNECT per le API HTTPS di modelli?
Il controllo proxy dimostra che un'API LLM accetterà quell'IP?
Tutti i gateway LLM fanno retry, fallback e streaming allo stesso modo?
Articoli correlati
Che cosa sono i proxy residenziali e come funzionano
I proxy residenziali escono da indirizzi ISP consumer. Qui si spiegano pool, sessioni sticky, che cosa vedono i siti e che cosa chiedere a un fornitore prima di comprare.
4 minI migliori proxy per il web scraping nel 2026: una lista di controllo per chi compra
Un acquisto scraping nel 2026 parte dalla destinazione, non dal fornitore. Usi questa lista per origine, sessione, geo, fatturazione e un test live prima di salire di scala.
5 minProxy sticky e a rotazione: come funziona il controllo di sessione
Proxy sticky e a rotazione: come funzionano la rotazione a ogni richiesta e quella a timer, quando una sessione sticky batte un IP nuovo, come i cookie interagiscono con il cambio di IP e come testare un ID di sessione da sé.
