Proxy w Python Requests: uwierzytelnianie, limity czasu i błędy
Jak puścić Python Requests przez proxy HTTP albo SOCKS5: słownik proxies, logowanie użytkownik/hasło, zmienne środowiska, limity czasu oraz co naprawdę znaczą ProxyError, 407 i SSLError.
Ten poradnik jest dla programistów, którzy potrzebują, żeby Python Requests szedł przez proxy i nadal działał, gdy proxy się źle zachowuje. Przykłady używają zastępczych hostów i atrap danych logowania. Top Proxy nie sprzedaje adresów IP i nie rozdaje darmowych list; porównujemy usługi, które to robią.
Fragmenty celują w Requests 2.34.2 na PyPI, który potrzebuje Pythona 3.10 albo nowszego. Zachowanie proxy poniżej idzie za dokumentacją zaawansowanego użycia Requests. Kluczowe przypadki ponownie odpaliliśmy 2026-10-14 wobec przypiętej atrapy na loopback (Python 3.14.6, Requests 2.34.2, urllib3 2.8.0, PySocks 1.7.1, weryfikacja TLS włączona). To laboratorium pokazuje wyłącznie zachowanie protokołu, nie prędkość, lokalizacje ani jakość IP dostawcy.
01Minimalny przykład proxy w Python requests
Każda metoda żądania przyjmuje słownik proxies. Klucze to schemat URL celu; wartości to URL proxy:
import requests

proxies = {
    "http": "http://203.0.113.10:8080",
    "https": "http://203.0.113.10:8080",
}

r = requests.get("https://httpbin.org/ip", proxies=proxies, timeout=(3.05, 27))
print(r.status_code, r.json())
Na dwóch szczegółach ludzie się najczęściej potykają. Po pierwsze, klucz "https" zwykle wskazuje URL proxy http://. To poprawne: klient prosi proxy o tunel CONNECT, a TLS idzie w środku. https:// tam stawiać tylko wtedy, gdy dostawca kończy TLS na porcie proxy. Po drugie, URL proxy pisać z jawnym schematem (http://, https://, socks5:// albo socks5h://), żeby protokół był jednoznaczny. Requests 2.34.2 dopisuje http:// do zwykłego host:port bez schematu; to nie jest niepoprawny URL proxy. InvalidProxyURL jest rzucane, gdy po sparsowaniu ciąg nadal nie ma hosta, nie dlatego, że pominięto schemat.
httpbin.org/ip zwraca JSON z polem origin, które jest adresem, jaki zobaczył serwer. Porównać to z IP wyjścia albo zakresem, który dostawca dokumentuje dla planu, i zanotować bezpośredni adres na Jaki jest mój adres IP. Sam niezmieniony adres nie dowodzi, że proxy zostało ominięte. Część konfiguracji wychodzi tą samą siecią, w której siedzicie. Jeśli trzeba tylko wiedzieć, czy punkt końcowy odpowiada, użyć sprawdzania proxy albo dłuższego opisu jak sprawdzić, czy proxy działa.
Klucz scheme://hostname kieruje jeden dokładny host inaczej:
proxies = {
    "https": "http://203.0.113.10:8080",
    "https://api.internal.example": "http://198.51.100.5:3128",
}
To dopasowanie hosta jest dokładne. Nie dotyczy każdej nazwy pod tą samą domeną.
02Ustawienia proxy na Session (i pułapka środowiska)
Session ponownie używa połączeń i trzyma domyślne w jednym miejscu:
session = requests.Session()
session.proxies.update(proxies)
session.get("https://httpbin.org/ip", timeout=10)
Dokumentacja Requests ostrzega, że session.proxies może nie zachowywać się tak, jak byście oczekiwali. Wartości tam ustawione mogą być nadpisane przez proxy ze środowiska (cokolwiek zwraca urllib.request.getproxies()). Odziedziczone HTTPS_PROXY potrafi cicho wygrać. Dwa sposoby, żeby wybór był jawny:
# Option 1: pass proxies on every call (the documented fix)
session.get(url, proxies=proxies, timeout=10)

# Option 2: stop the session from reading the environment
session.trust_env = False
session.proxies.update(proxies)
trust_env = False zatrzymuje też czytanie .netrc i zmiennych pakietu CA takich jak REQUESTS_CA_BUNDLE.
To nie teoretyczne ostrzeżenie. W atrapie z 2026-10-14 Session.proxies wskazywało jedno proxy na loopback, a HTTP_PROXY / HTTPS_PROXY inne. Proxy ze środowiska dostało GET. Ta sama sesja, z proxies= przekazanym na wywołaniu, trafiła w proxy sesji. Druga sesja z trust_env = False użyła Session.proxies i zignorowała środowisko. Jeśli skrypt „losowo” używa proxy CI, patrzeć tutaj, zanim przepiszecie URL.
03Zmienne środowiska proxy w Python requests
Jeśli w ogóle nie przekażecie proxies, Requests czyta standardowe zmienne http_proxy, https_proxy, no_proxy i all_proxy. W zwykłym procesie wielkie nazwy też działają. To nie reguła HTTP curl, gdzie http_proxy jest małą zmienną dla HTTP. Jeden wyjątek CPython: jeśli ustawione jest REQUEST_METHOD (proces CGI), urllib.request.getproxies_environment() odrzuca mapowanie HTTP, które przyszło z HTTP_PROXY, żeby nagłówek klienta Proxy: nie mógł go wstrzyknąć. Małe http_proxy nadal może zadziałać.
export HTTP_PROXY="http://203.0.113.10:8080"
export HTTPS_PROXY="http://203.0.113.10:8080"
export NO_PROXY="localhost,127.0.0.1,.internal.example"
python my_script.py
Bez NO_PROXY wywołania do localhost albo usług wewnętrznych mogą iść przez proxy ze środowiska i wisić na limicie czasu. NO_PROXY rządzi tylko proxy zebranymi ze środowiska. Host pasujący do NO_PROXY nadal może iść przez proxy, jeśli przekażecie jawny słownik proxies=, który go pokrywa.
Atrapa potwierdziła obie strony. Przy NO_PROXY=127.0.0.1,localhost i bez argumentu proxies= GET poszedł prosto do lokalnego origin; żadne laboratoryjne proxy go nie zobaczyło. Ten sam host, z jawnym słownikiem proxies=, poszedł przez proxy, które przekazaliśmy. Dlatego błąd „działa w powłoce, nie w workerze” to często dwie różne ścieżki konfiguracji, nie dwie różne biblioteki.
| Skąd pochodzi ustawienie | Dotyczy | Kiedy tego użyć |
|---|---|---|
Argument proxies= na żądaniu | Tego jednego wywołania, nadpisując proxy ze środowiska | Skrypty, które muszą użyć konkretnego wyjścia, np. rotacja per żądanie |
Session.proxies | Każdego wywołania na tej sesji, chyba że środowisko je nadpisze | Długo żyjące klienty HTTP, najlepiej z trust_env = False |
HTTP_PROXY / HTTPS_PROXY / ALL_PROXY | Każdego wywołania Requests w procesie, które nadal ufa środowisku | Narzędzia trzecie i CI, gdzie nie da się edytować kodu |
NO_PROXY | Hostów, które pomijają proxy ze środowiska (jawne proxies= nadal może je pokryć) | Localhost, endpointy metadanych, wewnętrzne API |
04Uwierzytelnianie proxy w Python requests (nazwa użytkownika i hasło)
Większość płatnych proxy potrzebuje logowania. Requests obsługuje HTTP Basic dla proxy przez sam URL, http://user:***@host:port, w słowniku proxies albo w dowolnej ze zmiennych środowiska:
import os
from urllib.parse import quote

user = quote(os.environ["PROXY_USER"], safe="")
password = quote(os.environ["PROXY_PASS"], safe="")
host = "gate.example-provider.com:7000"

proxy_url = f"http://{user}:{password}@{host}"
proxies = {"http": proxy_url, "https": proxy_url}
Dane logowania ładować z menedżera sekretów w runtime. Dokumentacja Requests nazywa trzymanie ich w zmiennych środowiska albo w wersjonowanych plikach ryzykiem bezpieczeństwa. Percent-encode zarówno nazwę użytkownika, jak i hasło. Requests odkodowuje obie części wyciągnięte z URL, więc każde @, :, / albo # w którejkolwiek musi przejść przez quote(..., safe=""). Inaczej URL może się źle sparsować, a proxy nigdy nie zobaczy danych, które chcieliście wysłać. Po dekodowaniu HTTP Basic user-id nie może zawierać dwukropka (RFC 7617 sekcja 2); hasło może. Percent-encoding dwukropka w nazwie użytkownika nie czyni tego legalnym: Requests odkodowuje go z powrotem do dwukropka. Dodatkowy niezakodowany dwukropek w userinfo jest parsowany jako początek hasła (alice:bob:secret staje się użytkownikiem alice i hasłem bob:secret).
Flagi kraju albo sticky-session w nazwie użytkownika (user-country-us-session-abc123) to składnia dostawcy, nie cecha Requests. Same z siebie nie dają geografii ani konta.
W starszych odpowiedziach bywa też requests.auth.HTTPProxyAuth. Dokłada nagłówek Proxy-Authorization do obiektu żądania. W teście na loopback uwierzytelnił zwykłe żądania HTTP (200), ale żądanie HTTPS padło z ProxyError wspominającym 407. To pasuje do nagłówka jadącego na żądaniu, a nie na CONNECT, które proxy sprawdza. Preferować dane logowania w URL.
Requests obsługuje wyłącznie Basic auth proxy. Proxy NTLM albo Kerberos/Negotiate potrzebują biblioteki uwierzytelniania trzeciej strony albo lokalnego proxy-pomocnika.
Jeśli pytanie, które wpisaliście, brzmiało tylko „co znaczy 407?”, ten status ma własną stronę: 407 Proxy Authentication Required. Ten artykuł zostaje przy tym, jak Requests to pokazuje.
05Proxy SOCKS5 w requests
Obsługa SOCKS to opcjonalny dodatek, który ciągnie PySocks (1.7.1 na PyPI w momencie pisania):
python -m pip install "requests[socks]"
Potem URL SOCKS działają w tym samym słowniku proxies, razem z danymi logowania:
proxies = {
    "http": "socks5h://user:***@203.0.113.10:1080",
    "https": "socks5h://user:***@203.0.113.10:1080",
}
Zwracać uwagę na h. Przy socks5:// rozwiązywanie DNS dzieje się na waszej maszynie i do proxy idzie tylko wynikowy IP. Przy socks5h:// proxy rozwiązuje nazwę hosta. To ten sam podział, którego używa curl.
Atrapa uczyniła to widocznym na https://example.com/. Oba schematy zwróciły 200. Serwer SOCKS zapisał ATYP 1 (IPv4, 172.66.147.243) dla socks5:// i ATYP 3 (nazwa hosta example.com) dla socks5h://. Wywołania HTTP do 127.0.0.1 tej różnicy nie pokazują, bo IP już jest adresem. Używać socks5h, gdy nie chcecie, żeby lokalny resolver widział lookupy. Porównanie protokołów w języku katalogu: SOCKS5 a HTTP.
| Schemat URL proxy | Potrzebny dodatek | Kto rozwiązuje DNS | Typowe użycie |
|---|---|---|---|
http:// | Brak | Proxy, dla nazwy hosta, o którą prosicie | Większość płatnych bram HTTP(S) |
https:// | Brak | Proxy | Dostawcy, którzy kończą TLS na porcie proxy |
socks5:// | requests[socks] | Wasza maszyna | Proxy SOCKS, gdzie lokalny DNS jest akceptowalny |
socks5h:// | requests[socks] | Proxy | Proxy SOCKS, lookupy DNS zostają po stronie proxy |
Niepewność, jakim protokołem mówi punkt końcowy? Puścić go przez sprawdzanie proxy.
06Limit czasu proxy w Python requests
Requests nie ma domyślnego limitu czasu, więc zacięte proxy może wisieć na wywołaniu minutami. Zawsze przekazywać timeout, najlepiej jako krotkę (connect, read):
r = requests.get(url, proxies=proxies, timeout=(3.05, 27))
Wartość connect pokrywa połączenie TCP, co przy proxy znaczy połączenie do proxy. Dokumentacja sugeruje wartość nieco powyżej wielokrotności 3, żeby zgrać się z retransmisją TCP. Wartość read to maksymalna przerwa między bajtami od serwera, nie pułap całkowitego czasu pobrania. Opóźnienie zależy od dostawcy, wyjścia i celu, więc wartość read ustawiać z czasów odpowiedzi zmierzonych na rzeczywistym punkcie końcowym.
Przydatna pułapka: gdy samo proxy nie przyjmuje połączenia TCP na czas, Requests 2.34.2 rzuciło ProxyError opakowujące ConnectTimeoutError urllib3, nie najwyższego poziomu ConnectTimeout. W atrapie timeout=(1.0, 5) wobec 192.0.2.1:8080 dało ten wrapper. Po połączeniu z działającym proxy wolny origin z timeout=(3.05, 1.0) rzucił ReadTimeout. Łapać ProxyError i ReadTimeout przed ogólnym ConnectionError i oglądać komunikat albo __cause__, jeśli trzeba odróżnić „proxy nigdy nie odpowiedziało” od „proxy odpowiedziało, a potem strona umilkła”.
Dla przejściowych awarii montować adapter z ograniczonymi ponowieniami, zamiast pisać pętlę ręcznie:
from requests.adapters import HTTPAdapter
from urllib3.util import Retry

retry = Retry(total=3, backoff_factor=0.5, status_forcelist=[429, 502, 503, 504])
session.mount("https://", HTTPAdapter(max_retries=retry))
session.mount("http://", HTTPAdapter(max_retries=retry))
Ponowienia kodów statusu podążają za allowed_methods. Domyślny zbiór urllib3 2.8.0 to GET, HEAD, PUT, DELETE, OPTIONS i TRACE; POST jest wyłączony, dopóki go nie dodacie. Włączać ponowne wysłanie tylko dla operacji, które wolno wysłać dwa razy. total=3 ogranicza próby ponowienia, nie czas zegarowy. Gdy odpowiedź ma Retry-After, urllib3 czeka na to opóźnienie, jeśli respect_retry_after_header jest true (domyślnie).
Ponowienia nie naprawią 407, złego CA ani trust_env wskazującego złą bramę. Pomagają tylko wtedy, gdy awaria naprawdę jest przejściowa.
07Błędy proxy w Python requests: co znaczy każdy wyjątek
Kolejność bloków except ustawiać ostrożnie. ProxyError, SSLError i ConnectTimeout wszystkie dziedziczą po ConnectionError, a ConnectTimeout jest też Timeout. Najpierw łapać te konkretne:
from requests.exceptions import (
    ProxyError, SSLError, ConnectTimeout, ReadTimeout,
    ConnectionError, InvalidProxyURL, RequestException,
)

try:
    r = session.get(url, proxies=proxies, timeout=(3.05, 27))
    r.raise_for_status()
except ProxyError as e:
    ...  # proxy unreachable, CONNECT refused, or connect-timeout to the proxy; check the message for 407
except SSLError as e:
    ...  # certificate problem; fix trust, don't disable verification
except ConnectTimeout:
    ...  # could not connect in time (more often seen without a proxy)
except ReadTimeout:
    ...  # connected, but the server went quiet
except InvalidProxyURL:
    ...  # malformed proxy URL
except ConnectionError:
    ...  # DNS failure, reset, other network errors
except RequestException:
    ...  # anything else from requests
| Objaw | Prawdopodobna przyczyna | Co spróbować |
|---|---|---|
ProxyError bez 407 w komunikacie | Nic nie przyjmuje połączeń na tym hoście/porcie, proxy leży, blokada sieci/listy dozwolonych albo connect timeout do proxy | Sprawdzić host i port, potem przetestować punkt końcowy w sprawdzaniu proxy; dane logowania nie są pierwszym podejrzanym |
ProxyError wspominający 407 na URL HTTPS | CONNECT nie niósł danych, które proxy przyjęło: nic nie wysłano, ustawiono tylko przez HTTPProxyAuth, źle zakodowano, zły format albo plan nieaktywny | Wstawić zakodowane dane do URL proxy; potwierdzić format nazwy użytkownika i status planu |
| Odpowiedź ze statusem 407 na URL HTTP | Proxy prosi o dane logowania; na żądaniu wysłanym bez nich to po prostu wyzwanie | Dodać dane do URL proxy; jeśli już tam były, sprawdzić kodowanie i format |
| Odpowiedź ze statusem 401 | Cel, nie proxy, chce uwierzytelniania | Naprawić własne auth witryny; część proxy zadziałała |
Requests ignoruje wasze Session.proxies | Proxy ze środowiska je nadpisują | Przekazywać proxies= per wywołanie albo ustawić trust_env = False |
InvalidSchema: Missing dependencies for SOCKS support | Nie zainstalowano requests[socks] | python -m pip install "requests[socks]" |
SSLError: CERTIFICATE_VERIFY_FAILED | Proxy przechwytujące albo laboratoryjny/self-signed certyfikat, któremu domyślny pakiet nie ufa | Wskazać verify= albo REQUESTS_CA_BUNDLE na plik CA tego proxy |
| Wisi w nieskończoność | Nie ustawiono timeout | Zawsze przekazywać krotkę (connect, read) |
origin nie zgadza się z oczekiwanym wyjściem | Proxy nie zastosowane dla tego schematu, NO_PROXY pasowało przy poleganiu na proxy ze środowiska, albo inna trasa niż zakładaliście | Ustawić oba klucze http i https; przy proxy ze środowiska sprawdzić NO_PROXY; porównać z udokumentowanym IP/zakresem wyjścia dostawcy |
Co pokazał lokalny test
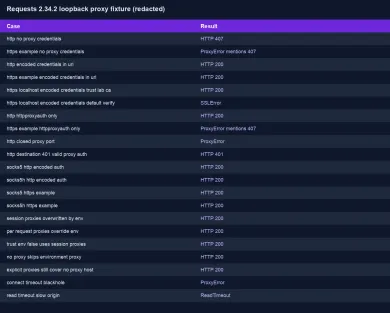
Te wzorce odpaliliśmy wobec testowego proxy na loopback 2026-10-14: Python 3.14.6, Requests 2.34.2, urllib3 2.8.0, certifi 2026.07.22, PySocks 1.7.1, timeout=(3.05, 10) o ile nie zaznaczono inaczej, weryfikacja TLS włączona. Atrapa użytkownika demo; hasło zawierało interpunkcję i było percent-encoded w URL, potem zredagowane w logach. Sprawdzenia HTTPS używały https://example.com/ plus lokalnego serwera z laboratoryjnym CA. Wiersze poniżej to zapisane obserwacje z tej atrapy, nie liczba zaliczonych testów automatycznych. To pokazuje wyłącznie zachowanie protokołu.
| Przypadek | Cel HTTP | Cel HTTPS |
|---|---|---|
| Brak danych logowania proxy | odpowiedź 407 | ProxyError wspominający 407 |
| Percent-encoded dane w URL proxy | 200 | 200 (example.com i laboratoryjny TLS z verify= ustawionym na laboratoryjne CA) |
Tylko HTTPProxyAuth | 200 | ProxyError wspominający 407 |
| Port proxy zamknięty | ProxyError, bez 407 | nie testowane |
| Poprawne auth proxy, witryna zwraca 401 | odpowiedź 401 od witryny | nie testowane |
| Domyślne CA kontra laboratoryjny samopodpisany certyfikat | n/d | SSLError: CERTIFICATE_VERIFY_FAILED; 200 po zaufaniu laboratoryjnemu CA |
Session.proxies kontra HTTP_PROXY | Proxy ze środowiska dostało GET | nie testowane |
proxies= na wywołaniu, środowisko ustawione | Sesja/otwarte proxy dostało GET | nie testowane |
trust_env = False | użyte Session.proxies; środowisko zignorowane | nie testowane |
NO_PROXY pasuje do hosta | Prosto do origin; brak trafienia proxy | nie testowane |
Jawne proxies= na hoście z NO_PROXY | Nadal przez proxy | nie testowane |
| Connect timeout do proxy | ProxyError opakowujące ConnectTimeoutError | nie testowane |
| Read timeout przez działające proxy | ReadTimeout | nie testowane |
SOCKS5 z zakodowanymi danymi zwróciło 200 dla HTTP i dla https://example.com/. Podział DNS: socks5:// dostarczyło do proxy adres IPv4; socks5h:// dostarczyło nazwę hosta.
Certyfikaty, proxy przechwytujące i verify
Korporacyjna brama inspekcji TLS albo lokalne proxy przechwytujące podpisuje HTTPS własnym urzędem certyfikacji, którego Requests odrzuca. Zaufać temu CA jawnie, zamiast wyłączać weryfikację:
r = requests.get(
    url,
    proxies={"https": "http://127.0.0.1:8080"},
    verify="/path/to/proxy-ca.pem",
    timeout=10,
)
albo export REQUESTS_CA_BUNDLE=/path/to/ca.pem dla całego procesu. Eksport DER najpierw przekonwertować do PEM. Laboratoryjny samopodpisany origin odtworzył tę samą klasę awarii: domyślne verify=True rzuciło SSLError (certificate verify failed: self-signed certificate); to samo żądanie z verify= wskazującym laboratoryjne CA zwróciło 200. verify=False sprawia, że Requests przyjmuje dowolny certyfikat i ignoruje niezgodność nazwy hosta, co rozbraja TLS dla wszystkiego, co ten klient wysyła. To nie jest normalna naprawa proxy, które „nie działa”.
08Rotacyjne proxy w Pythonie
Wielu komercyjnych dostawców rotuje wyjście za jednym hostem bramy. Zależnie od taryfy wyjście może zmieniać się per żądanie albo w interwale sesji, a identyfikator sesji w nazwie użytkownika zwykle przypina jedno wyjście na jakiś czas, zamiast dawać każdemu wywołaniu nowe. Te reguły to ustawienia dostawcy, więc sprawdzić ich dokumentację. Sticky a rotacyjne proxy opisuje język produktu. Jeśli sami zarządzacie listą punktów końcowych, wybierać jeden per żądanie i przekazywać go przez proxies=:
import itertools

pool = itertools.cycle(
    [
        "http://user:***@203.0.113.10:8080",
        "http://user:***@203.0.113.11:8080",
    ]
)

for url in urls:
    p = next(pool)
    session.get(url, proxies={"http": p, "https": p}, timeout=(3.05, 27))
Przekazywać proxy per wywołanie, bo proxy ze środowiska mogą nadpisać Session.proxies. Typ wyjścia to osobny wybór: datacenter, rezydenckie albo mobilne. Cena i to, jak witryna celu traktuje ruch, zależą od taryfy, celu i reputacji IP, nie od samej etykiety typu. Proxy samo z siebie nie nadaje geografii ani uprawnienia do konta.
Zanim kupicie, potwierdzić, że wybrany plan obsługuje protokół (HTTP albo SOCKS5) i metodę auth (login albo lista dozwolonych IP), których potrzebuje kod. Automatyzacja przeglądarki to inny stos; konteksty Playwright są w Proxy w Playwright. Dostawcy w naszym katalogu z bramami proxy:
Bright Data to duża sieć proxy do zbierania danych: IP rezydenckie, mobilne, ISP i datacenter w około 195 krajach. Ruch rezydencki można płacić na bieżąco bez subskrypcji, a adresy datacenter i ISP przychodzą w pakietach od 10 IP. Dostęp rezydencki i mobilny wymaga weryfikacji tożsamości.

Oxylabs sprzedaje proxy rezydenckie, mobilne, ISP i datacenter w jednej subskrypcji miesięcznej od $30. Płatności: karty, przelew, AliPay, PayPal.
SOAX sprzedaje rotacyjne proxy rezydenckie i mobilne na wspólnej puli kredytów, z datacenter i ISP w tych samych planach. Builder od $200/mies. + VAT (200 kredytów); ruch Tier 1 to $3/GB na Builderze.

Decodo (dawniej Smartproxy) sprzedaje proxy rezydenckie i datacenter. Rezydenckie: $4/GB bez planu miesięcznego albo pakiety miesięczne od $3.75/GB za 3 GB. Płatności: karty, PayPal, Alipay, Google/Apple Pay, krypto (z ograniczeniami).
Jak użyć proxy z Python requests?
Jak dodać nazwę użytkownika i hasło do proxy requests?
Dlaczego Python requests zwraca 407 Proxy Authentication Required?
Czy requests obsługuje proxy SOCKS5?
Czy requests używa zmiennej środowiska HTTP_PROXY?
Jaki timeout ustawić dla requests przez proxy?
Czy ustawić verify=False, jeśli proxy psuje HTTPS?
Powiązane artykuły
Czym są proxy rezydenckie i jak działają
Proxy rezydenckie wychodzą przez adresy konsumenckich ISP. Tu jest, jak działają pule, sesje sticky, co widzą witryny i o co pytać dostawcę przed zakupem.
4 minNajlepsze proxy do web scrapingu w 2026: lista kontrolna kupującego
Zakup proxy do scrapingu w 2026 zaczyna się od celu, nie od sprzedawcy. Ta lista kontrolna obejmuje pochodzenie, sesję, geo, rozliczenie i żywy test, zanim przeskalujecie.
5 minSticky a rotacyjne proxy: sterowanie sesją wyjaśnione
Sticky a rotacyjne proxy: jak działa rotacja na żądanie i na timerze, kiedy sesja sticky bije nowy IP, jak ciasteczka reagują na zmianę adresu i jak samodzielnie przetestować identyfikator sesji.
9 min
